前置知识与研究动机
扩散模型基础回顾
LDM
最原始的 DDPM直接在像素级别上加噪和去噪会导致计算量极大。而这篇论文中大量使用的 Stable Diffusion(SD)系列模型,是基于 LDM 的。 核心区别:LDM 首先用一个 VAE 将高维的像素图像压缩到一个低维的“潜空间”中,然后在潜空间里进行 DDPM 扩散和去噪过程,最后再用 VAE 解码会图像。
文本条件注入
文本特征提取
模型并不会直接处理文字,当输入提示词时,系统会使用预训练的语言模型(比如 CLIP 的 Text Encoder)将文本转化为高维的文本嵌入向量(Text Embedding)。在本文的公式里,文本条件通常被表示为 。
文本嵌入向量 文本嵌入向量是一个序列(类似二维矩阵),以 SD 1.5 为例,它使用 CLIP 文本编码器。当输入一段提示词时,它会做如下处理:
- 分词:把文本切成一个个 Token。SD 固定输入 77 个 Token。编码器会在实际的 token 后面加上一个特殊的结束符
<end-of-text>,然后用预设的填充符<pad>把序列硬凑到 77 的固定长度。在标准的 Transformer 架构中,会使用注意力掩码(Attention Mask)。它会在计算 Softmax 之前,将这些
<pad>token 对应的注意力权重设为极小的负数(负无穷大),这样 Softmax 之后它们的权重就是 0,完全不会干扰图像的生成。不过,在 Stable Diffusion 的具体工程实现中,有时即使没有严格屏蔽,模型在海量数据训练下也已经学会了将这些<pad>向量的注意力权重降到极低,视其为“无用信息”。- 向量化:每个 Token 会被映射成一个高维向量。在 SD 1.5 中,这个维度是 768。
- 最终维度:所有,提示词经过编码后,输出的张量维度是 (长度为 77 的序列,每个元素是 768 维的向量)。
文本特征注入
在基于 U-Net 的 Stable Diffusion 中,文本向量并不像时间步 t 那样简单相加。它主要是通过交叉注意力机制(Cross-Attention)交叉注意力注入到模型内部的。 可以把图像当前的视觉特征当做 Q,把文本嵌入向量当做 K 和 V。这样,图像在不断去噪的过程中,不同的空间位置就能关注到与之相对的文本语义。
CFG
CFG 无分类器引导(CFG)的核心机制是在训练时,同时训练模型预测有条件噪声 和无条件噪声 (做法是在训练中随机把一部分文本向量替换为空向量)。在推理时,通过外推公式放大文本的影响力: 这里的 就是引导尺度,用于控制生成图像与文本的契合程度。 论文中明确提到了 ControlNeXt 的设计在与 CFG 结合使用时尤其有利,能够获得最佳的生成结果。
主流空间可控生成方法及其痛点
标准的 Diffusion 模型只能通过文本提示词来控制生成的画面。但如果我们需要精确的空间控制(比如让人摆出特定的姿势、或者根据线稿生成图像),单纯的文字就无能为力了。 为了解决这个问题,业界之前提出了两种主流方案:ControlNet 和 T2I-Adapter。
空间控制信号
与文本这种一维序列不同,空间控制信号本身就是 2D 的图像结构。论文中展示了四种控制条件。
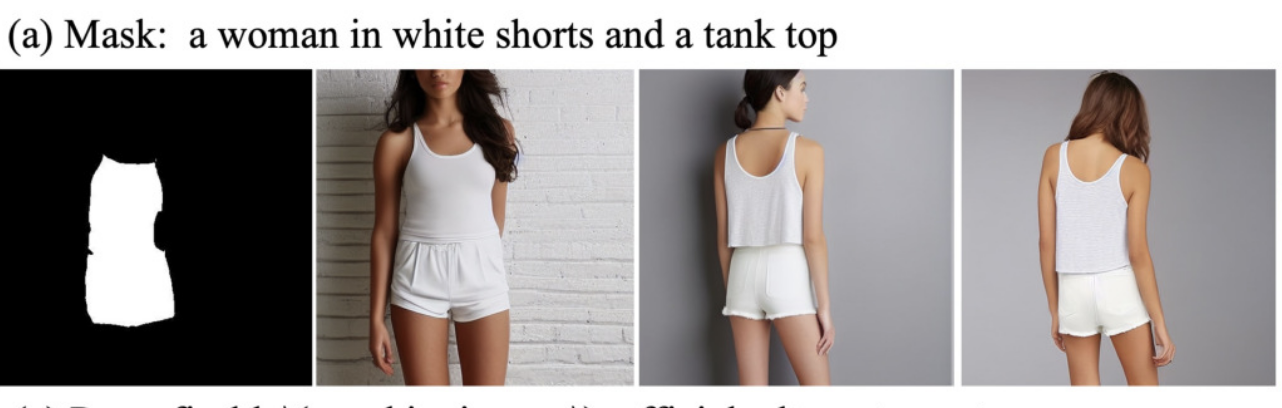
Mask(掩码)
用来约束物体的形状和位置。通常是黑白图或者多色图,比如论文中展示的例子(下图),目标区域(女生的吊带和短裤)是白色的,背景是黑色的。它告诉模型“在这个白色轮廓里生成指定的东西”。
Depth(深度图)
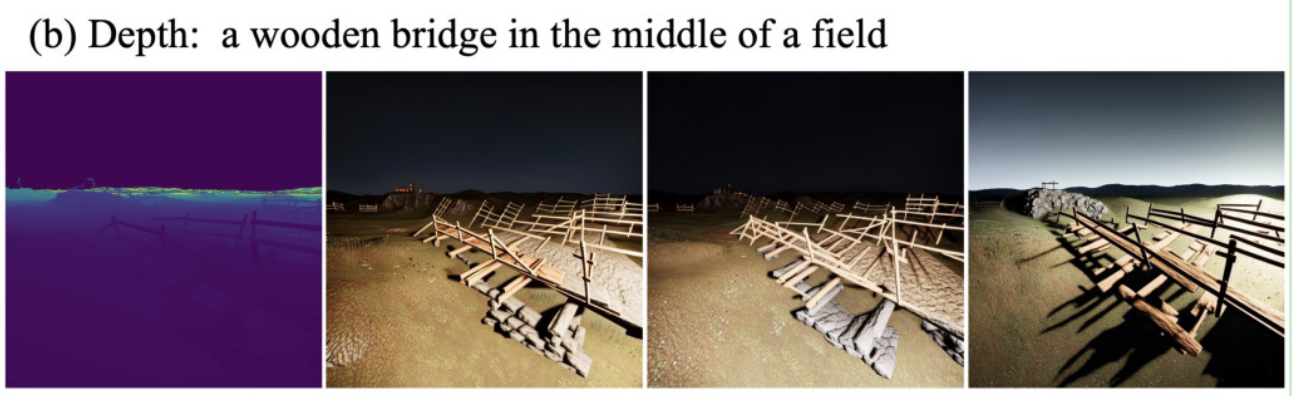
用来表示场景的三维空间层次。深度图通常是一张灰度图或伪彩色图,像素颜色的深浅代表了物体距离相机的远近(比如近处的物体亮,远处的物体暗)。它能让模型生成具有正确透视关系的图像。
Pose(姿态)
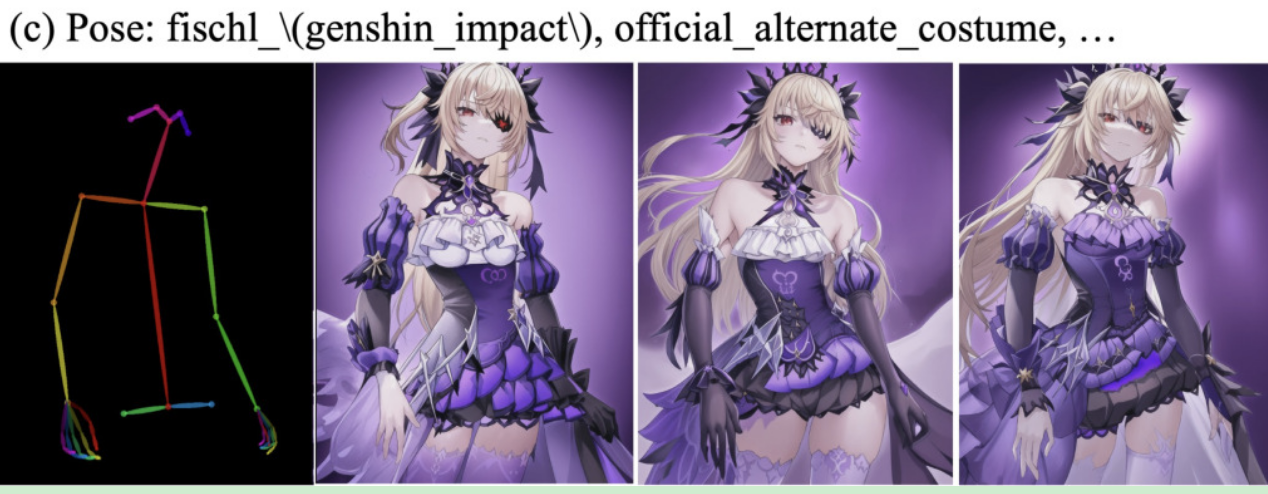
用来精确控制人物的动作。通常使用 OpenPose 等姿态估计算法提取,画面上是一堆像“火柴人”一样的彩色骨骼线段,标记了人体的头部、肩膀、手肘、膝盖等关键点。
Canny(边缘)
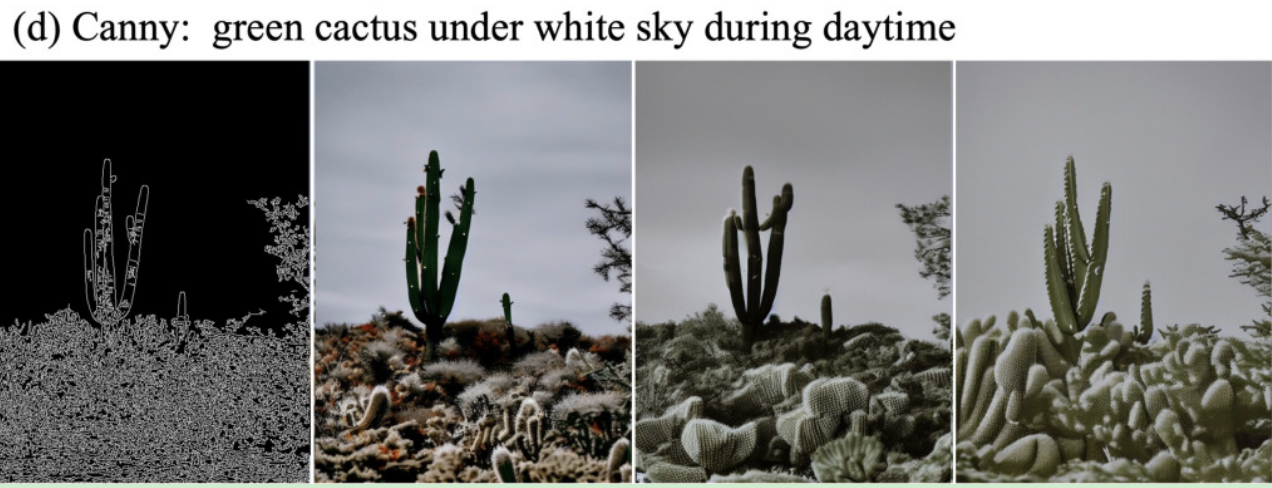
用来提取图像的硬轮廓和线条边界。Canny 是一种经典的边缘检测算法,提取出来的就是一张线稿(黑底白线),非常适合做风格迁移,比如论文中将普通的风景照通过 Canny 线稿生成出特定风格的图像。
ControlNet
原理
- 它将预训练好的基础大模型完全冻结,然后复制一份主 U-Net 的全部下采样块(Encoder)以及中间的瓶颈层作为平行的控制分支。
- 控制图输入到这个复制的控制分支中进行前向传播。
- 控制分支的每一层下采样输出,以及瓶颈层的输出,都会先经过一个“零卷积”。
零卷积: 为了防止新增的随机权重破坏基础模型的生成能力,ControlNet 使用了权重初始化为 0 的 卷积作为桥梁。
- 然后,这些特征会通过加法,直接加到主 U-Net 对应层的解码器的跳跃连接上。
特征融合的过程:
- 特征对齐:假设主 U-Net 编码器传过来的跳跃连接特征通道数是 。ControlNet 复制出来的控制分支,在经过“零卷积”输出时,其通道数也会被强制映射为 。
- 融合方式: ControlNet 将这两部分特征进行相加:。因为是逐元素相加,融合后的通道数依然是 。
- 进入解码器: 随后,这个融合后的特征(通道数为 )会和主 U-Net 解码器上一层上采样过来的特征进行常规的通道拼接。假设上采样特征通道数也是 ,那么送入下一层解码器模块的总通道数就是 。
痛点
由于复制了半个 U-Net,它引入了极大的参数量和计算延迟。此外,零卷积会导致训练初期模块无法获得准确梯度,出现“突然收敛”现象——即模型要训练很久才能突然学会受控。
T2I-Adapter
原理
为了降低成本,它不复制庞大的 U-Net ,而是单独训练一个小型的适配器(Adapter)网络来提取多尺度控制特征,然后注入到冻结的基础模型中。 Adapter: Adapter 最初来自自然语言处理领域的 PEFT (参数高效微调)技术。它的核心思想是:与其微调整个庞大的预训练模型,不如在模型外部或层与层之间,插入几个很小的神经网络模块(即 Adapter),只训练这些小模块。 T2I-Adapter 架构非常简单,且完全独立于主 U-Net。
- 全卷积特征提取:对于深度图、Canny 边缘等 2D 空间条件,Adapter 本质上是一个小型的前馈卷积神经网络。它通常由 4 个特征提取模块组成,每个模块主要包含简单的卷积层(Conv)或残差块(ResNet block)以及下采样层。
- 多尺度输出:如果输入一张 的条件图,Adapter 会像阶梯一样,依次提取出尺寸为 、、 和 的特征图。这刚好对应了 SD U-Net 编码器的四个不同分辨率的中间阶段。
- 注入位置: T2I-Adapter 把这些多尺度的控制特征,逐元素相加到了主 U-Net 编码器对应的中间特征层上。
- 兵分两路:相加融合之后的这个“新特征”,接下来会兵分两路:
- 向下(走编码器):作为输入,喂给编码器的下一层,继续进行下采样和特征提取。
- 向右(走跳跃连接):直接通过 U-Net 的跳跃连接,原封不动地传递给对面对应的解码器层。
痛点
T2I-Adapter 牺牲了控制能力来换取效率 。它只有几十兆(M)的参数,且在特征刚进入 U-Net 编码器阶段就早早注入了。由于主 U-Net 是完全冻结的,这些微弱的控制信号在深层网络的前向传播中很容易被原有的强大生成能力“稀释”掉,所以在面对复杂任务(如视频生成)时显得力不从心 。
核心动机
论文作者认为,基础的大型生成模型本身已经足够强大,完全可以直接学习如何受控,而不需要像 ControlNet 那样外挂一个庞大且沉重的辅助组件。
- 参数冗余问题:ControlNeXt 抛弃了复制网络的做法,只使用了一个轻量级的卷积模块来注入控制信号,并通过选择性地微调基础模型的一小部分参数,就减少了高达 90% 的可学习参数。
- 零卷积灾难:在 ControlNet 中,为了不让新加入的控制分支在训练初期破坏预训练模型的能力,它使用了“零卷积”作为桥梁 。但这会导致收敛非常慢,因为在训练刚开始时,这些模块很难接收到正确的梯度,从而产生一种模型训练很久后才突然学会控制的“突然收敛”现象 。
- ControlNeXt 的解法:论文提出了一种叫 Cross Normalization 的技术来替代零卷积,通过对齐数据分布来让模型在初期就能获得稳定的梯度,从而实现更快的收敛。
核心网络架构设计
在前文,我们明确了 ControlNet 的痛点(太重、外挂太多)和 T2I-Adapter 的痛点(太轻、控制力弱)。在论文的 3.2 Architecture 节中,作者提出了一个非常反直觉但绝妙的思路:为什么非要外挂一个网络?基础大模型本身已经见识过几十亿张图片(比如 LAION-5B 数据集),它足够强大,完全可以直接学习如何控制自己。
ControlNet 的数学表达
在论文公式 (5) 中,作者给出了 ControlNet 的前向传播公式:
- :输入的潜空间图像特征 。
- :输入的控制信号 。
- :这是被完全冻结的预训练基础模型主分支 。
- :这就是那个庞大的“外挂”——复制出来的 ControlNet 控制分支。 代表它那海量的可学习参数。
- :这是零卷积层,它负责把控制特征加回到主模型中。 可以清楚的看到,主模型 啥都没学,所有的控制压力全压在了新加的 身上,这就导致了参数量暴增和计算延迟。
ControlNeXt 的数学表达
接下来,我们看论文给出的 ControlNeXt 核心公式 (6): 这个公式非常简洁,但蕴含了论文最重要的两个创新:
抛弃庞大分支,改用极轻量卷积模块
作者直接砍掉了ControlNet 复制的半个 U-Net,仅仅使用了一个非常小型的卷积模块(只包含几个卷积块)来处理控制条件 。 这个模块的参数 非常少( ,即远小于主模型的参数量)。 它唯一的作用,仅仅是把控制信号提取出来并进行对齐 ,而不是像 ControlNet 那样还要负责庞大的特征融合计算。
(部分微调 Partial Tuning)
论文明确指出 ,也就是主模型参数的一个子集 。 ControlNeXt 不再完全冻结基础大模型,而是“解冻”了其中极小的一部分参数(比如注意力模块中的线性层)让它们参与训练。 解冻之后,便可以让大模型自己去适应控制信号,因为绝大多数参数还是冻结的,所以不会发生“灾难性遗忘”(也就是不会破坏原本强大的画图能力);同时,因为直接微调了主模型,它的控制力比仅仅加在编码器外围的 T2I-Adapter 要强大得多,特别适合处理视频生成这种复杂任务。
控制信号注入时机
作者在实验中发现,如果把控制特征直接和带有强噪声的输入 混在一起,会导致“训练崩溃” 。这是因为控制信号和去噪特征重叠在一起,模型直接“懵了”。
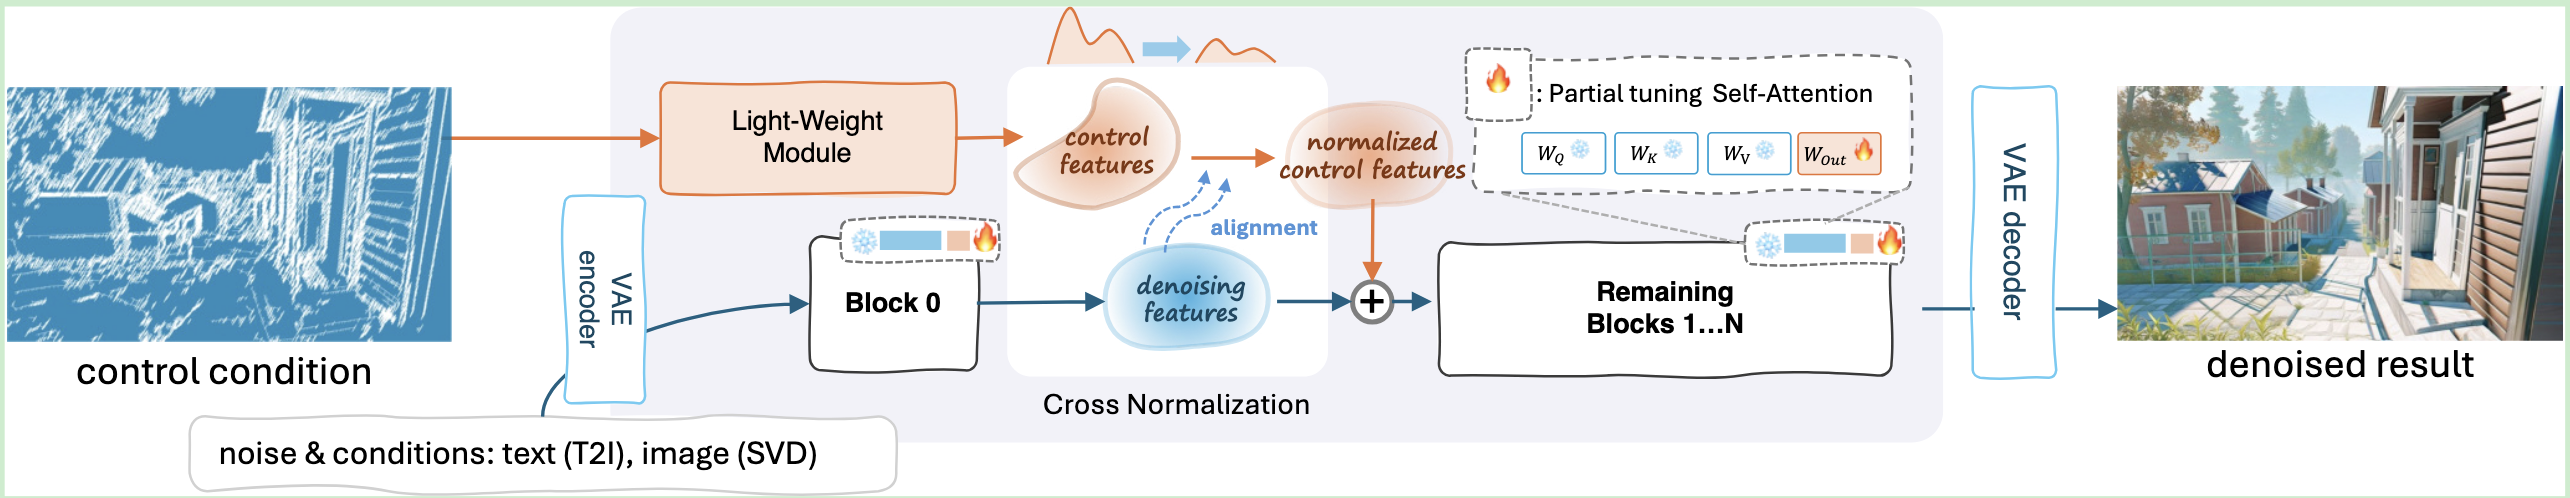
为了让模型尽早感知到控制信息,作者选择在第一个 Block(Block 0)之后注入控制信号,并且加入了一个残差连接来保护主干网络的完整性。
结合论文的 Figure 2 来看:控制条件(control condition)经过轻量级模块(Light-Weight Module)后,在主模型的 Block 0 之后,通过一个加号 + 与主干特征融合,然后一起送入后续的 Block 1…N 。
 这就完美解决了当前主流方法“既要轻量,又要控制力强”的矛盾。
核心数学创新
训练崩溃的原因
在微调大型预训练模型时,如果直接把新初始化的模块加进去,会导致训练直接崩溃。为了解决这个问题,ControlNet 引入了零卷积,但是也引发了”突然收敛“现象。 作者深入思考了训练崩溃的原因,他们认为,训练崩溃的元凶其实是数据分布不匹配:
- 主模型特征:预训练大模型由于在海量数据上训练过,它的中间特征已经形成了非常稳定、具有一致均值和标准差的数据分布。
- 控制条件特征:新引入的控制模块通常是随机初始化的(比如高斯初始化) 。它输出的特征分布是混乱的,与主模型的特征分布天差地别。
- 把这两个分布完全不同的张量直接相加,瞬间就打破了原有的稳定,导致模型崩溃 。
交叉归一化
既然问题出在分布不匹配,那最直接的解法就是:把控制特征的分布,强行拉平到和主模型特征一样的分布。这就引出了论文 3.3 节的公式推导。 设主模型的去噪特征为 ,轻量级卷积模块提取的控制特征为 。 和 的维度均是 。 步骤一:计算主模型特征的统计量 首先,计算主干分支特征 的通道级均值 和方差 : 这里的 ,即特征图上所有元素的总数。 步骤二:对控制特征进行“交叉归一化” 接下来,这是最关键的一步。作者没有使用 自己的均值和方差,而是借用主模型的均值 和方差 来对控制特征 进行归一化:
- 是一个极小的常数,防止分母为 0(数值稳定性)。
- 是一个可学习的缩放参数。 步骤三:平滑注入 经过 Cross Normalization 处理后, 的数据分布已经与主模型特征 高度一致 。此时,将它们直接相加(),不仅不会引起训练崩溃,而且因为去掉了零卷积,梯度从第一步开始就能顺畅地反向传播。
通过这个极其优美且计算量极小的 Cross Normalization,ControlNeXt 彻底抛弃了零卷积,使得模型只需几百步就能开始收敛,大大缩短了训练时间,并一举解决了“突然收敛”的难题。
实验结果与性能
破解”突然收敛“
在论文的 4.1 节,作者直接用图表(Figure 3)甩出了 Cross Normalization 的威力。
对比结果:在同样的控制条件(比如 Canny 边缘或 Pose 姿态)下,传统的 ControlNet 因为零卷积的拖累,需要训练大约 20,000 步才能让图像完全贴合控制条件 。而 ControlNeXt 仅仅在 400 步左右就已经完美收敛,准确生成了符合条件的图像。
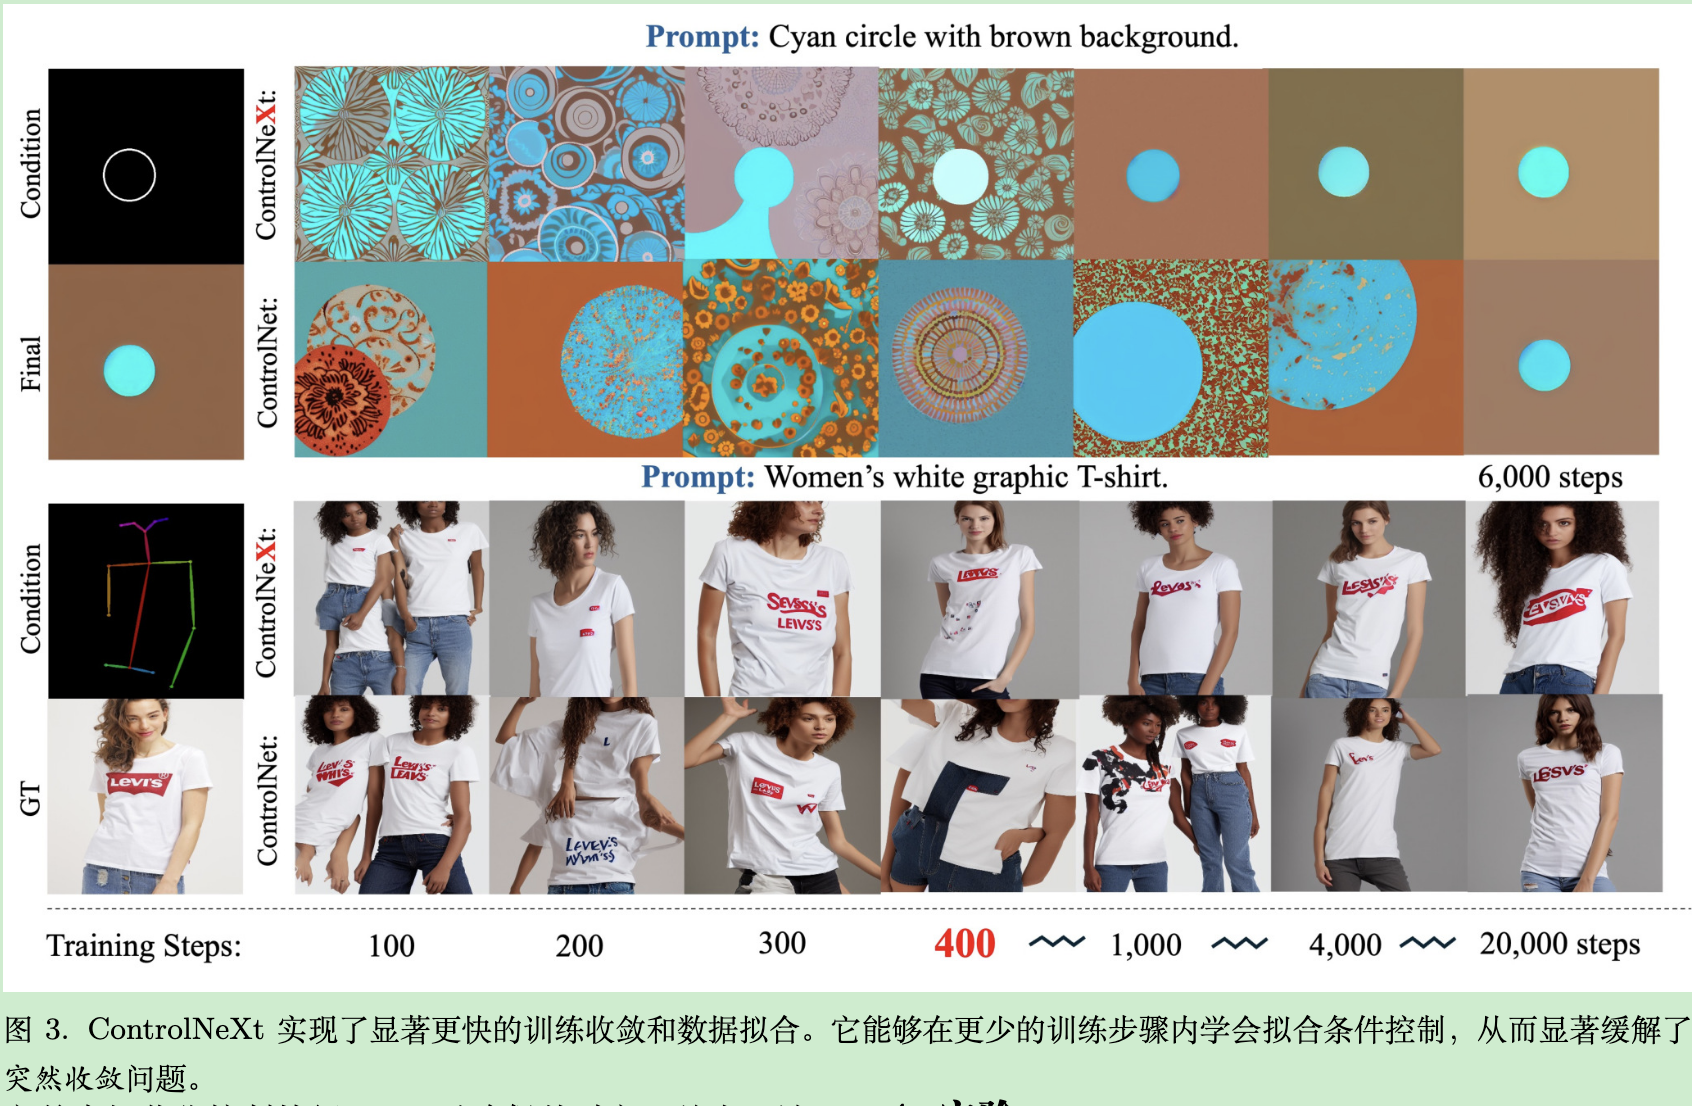 科研启发:这意味着在有限的算力下,采用Cross Normalization 对齐特征分布,可以极大地节约炼丹的时间成本,模块一开始就能吃满梯度,迅速学会控制。
极致的参数与推理效率
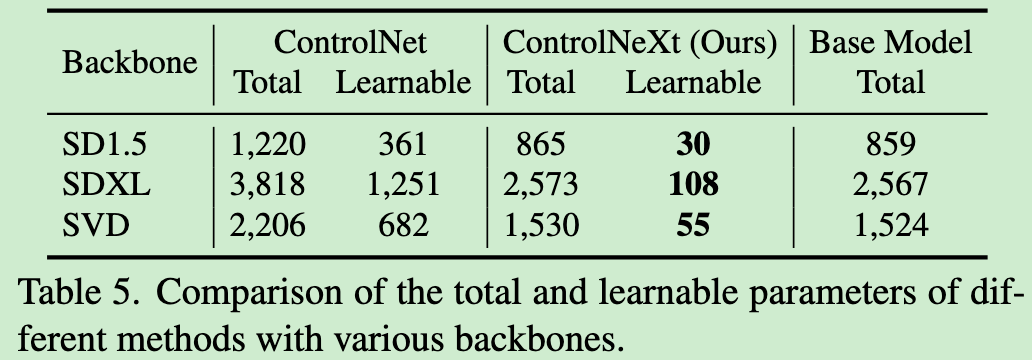
在4.3 节 的Table 5 中,作者详细对比了可学习参数量。
- 数据碾压:以极其庞大的 SDXL 模型为例,传统的 ControlNet 引入了高达 1251M 的可学习参数 。而 ControlNeXt 因为抛弃了复制网络,仅仅引入了 108M 的可学习参数 。参数量锐减了 90% 以上 。
- 推理速度:在 Table 6 中,ControlNeXt 的推理时间相比于完全没有控制的基础模型,仅仅增加了 10.4% 的延迟(SD1.5 从 0.22s 增加到 0.24s),而 ControlNet 增加了 41.9% 。
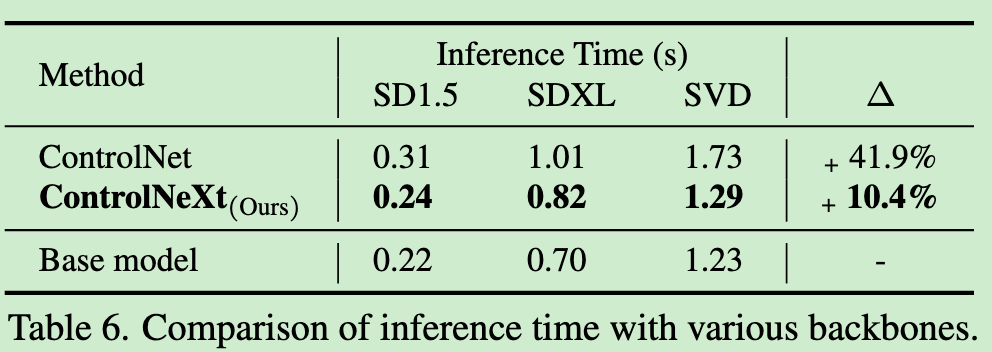
泛化性与即插即用
- 跨架构支持:在 4.2 节,作者证明了ControlNeXt 可以无缝接入 SD1.5、SDXL(高分辨率生成)、SD3 甚至是 SVD(视频生成)。尤其是在视频生成这种对算力要求极高、时序一致性要求极严苛的任务中,它依然能稳定发挥。
- 无缝兼容 LoRA:在 4.4 节,作者展示了 ControlNeXt 作为一个极其独立的轻量级模块,可以直接与社区里现有的各种 LoRA 权重结合使用,完全不需要重新训练(training-free)。这意味着可以用它控制姿态,同时用 LoRA 控制画风(比如图 8 展示的二次元风格、机甲风格等)。
training-free 免训练”
LoRA 结合时免训练。ControlNeXt 模块本身(轻量卷积模块的参数 和主干解冻的少量参数 )是必须要在成对数据集上预先训练好的。它的强大在于,一旦训练完成,利用交叉归一化对特征分布的动态对齐,它就能和社区里任意的画风 LoRA 直接像搭积木一样叠加使用,不会发生特征冲突。
个人思考与启发
DiT是用的 adaLN+Zero,这个零初始化能否改成交叉归一化?
AI解答:
1. 两者的核心目的极其相似
它们都是为了解决**“在预训练大模型中引入新条件时,如何保证训练初期的稳定性,避免破坏原始生成先验”**这个问题。
- adaLN-Zero:让 DiT Block 在初始化时退化为恒等映射(Identity Mapping),主干特征该怎么走还怎么走。
- Cross Normalization:让新加入的控制特征的数据分布强行向主干特征看齐,防止因为分布差异引发的训练崩溃。
2. 但它们处理的“对象”维度不同
-
DiT 的 adaLN-Zero 处理的是全局条件(如时间步 和文本标签 )。它是把这些 1D 的条件向量映射成缩放和平移参数( 和 ),去调制主干特征。由于它是对主干特征进行操作,把初始化的映射权重设为 0,刚好等价于“暂时不调制”。
-
ControlNeXt 的 Cross Normalization 处理的是空间结构条件(如 2D 的深度图、骨骼图)。因为空间控制通常是以独立分支提取特征(即你的 ),然后与主干特征()进行逐元素相加的。
3. 结论与实操建议
直接把处理时间步和文本的 adaLN-Zero 换成交叉归一化是不合适的,因为 adaLN 本身已经是一个归一化层了,Zero 初始化在处理 1D 全局变量调制时已经非常高效且收敛很快。
但是(这里是重点)!
如果你要在 DiT 架构上做空间可控生成(比如为 DiT 加上骨骼控制,类似于给 DiT 做一个 ControlNet),你需要把 2D 的骨骼图打成 Patch 序列并提取特征。当你要把这个骨骼特征序列加到 DiT 主干的 Patch 序列上时,绝对可以使用交叉归一化来替代零初始化(Zero Linear)!
事实上,这篇论文在 Table 2 和 Table 4 中,就在 SD3 和 Open-Sora-Plan(这两个都是基于 DiT 架构的模型)上成功应用了 ControlNeXt。他们本质上就是用交叉归一化对齐了空间控制特征和 DiT 主干特征。